
Написано для читателей, которые не читают
Большая часть аудитории в интернете сегодня — это машины.
Задайте вопрос чат-боту и понаблюдайте за тем, что происходит с веб-пространством, скрывающимся за ним. Чтобы сформировать ответ, бот «прочитывает» 30–40 страниц, отбирает нужную информацию и выдаёт вам лаконичный, аккуратный абзац. Вы не видите этих страниц и не переходите по ссылкам на них. Сайт, который «победил» (что бы это слово ни значило сегодня), получает лишь упоминание, набранное бледно-серым шрифтом, и ни одного реального посетителя.
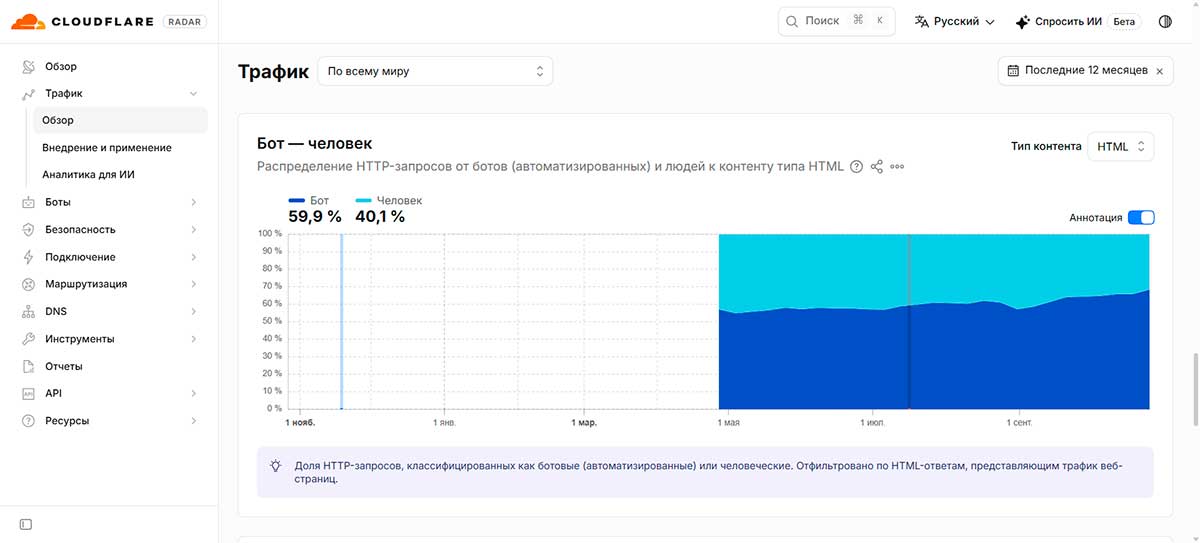
Именно так сегодня происходит большая часть потребления контента в интернете, и компании, управляющие сетевой инфраструктурой, видят эту картину воочию. В этом году в сети Cloudflare количество запросов к веб-страницам со стороны ботов превысило число запросов от людей: 57,5% против 42,5%. Генеральный директор компании отметил этот переломный момент ещё в июне — примерно на полтора года раньше собственного прогноза, связав такой всплеск активности с работой программных агентов, загружающих страницы по поручению пользователей.
Сегмент искусственного интеллекта растёт быстрее всех остальных: за прошлый год темпы его роста примерно в восемь раз превысили темпы роста посещаемости со стороны людей. Веб-контент читают активнее, чем когда-либо. Вот только читают его не люди.
Правила, по которым мы с вами выстраивали веб — правила, касающиеся качества, доступности и честности, — изначально писались для людей. Но аудитория изменилась. И правила теперь тихо, без всяких голосований, отменяют, подстраиваясь под новые реалии. Три из них уже сейчас уходят в прошлое…
Кто следит за порядком в вебе и зачем им это нужно
Более двадцати лет у веба был свой «регулировщик», и этим регулировщиком был Google. Стоило вам напичкать текст невидимыми для глаз ключевыми словами, закупить тысячу ссылок или наплодить страниц-дорвеев, как рано или поздно на вас обрушивалась кара свыше. Большинству казалось, что это просто «санитарные меры»: Google, мол, из чистого альтруизма наводит порядок в сети на благо всех пользователей.
На самом деле всё обстояло иначе. Google следил за порядком в Сети, поскольку продавал рекламу, привязанную к поисковому индексу, а индекс, забитый мусором, ценится рекламодателями ниже. Эта «чистка» была сродни наведению лоска на витрину магазина.
Энди Байо наблюдал подобную картину ещё десять лет назад: Google позволил сервису Google Books и своему новостному архиву прийти в упадок, как только те перестали приносить доход, и предостерегал от попыток доверить корпорации выполнение функций библиотеки. Впрочем, он ещё был к ним снисходителен. Библиотека всегда была лишь побочным продуктом рекламного бизнеса: её поддерживали, пока она приносила деньги, и бросали, когда переставала.
А теперь взгляните на новую аудиторию. Система, выдающая готовые ответы (answer engine), не продаёт рекламу на базе упорядоченного индекса, поскольку не хранит его в виде, доступном для просмотра пользователем. Она считывает информацию, оценивает найденное и воспроизводит лишь те фрагменты, которые считает нужными. Слабая страница не подвергается штрафным санкциям — её просто не выбирают для показа. С точки зрения самой страницы это даже хуже: ведь при наложении штрафа хотя бы приходило уведомление по электронной почте. Больше нет «надзирателя». Остался лишь швейцар, который никогда не объясняет, почему вас не пустили внутрь.
И самое забавное здесь то, что Google теперь совмещает обе эти роли. Компания по-прежнему управляет индексом, монетизируемым за счёт рекламы, — тем самым, который суд недавно признал незаконной монополией (как в сфере поиска, так и в сфере продажи сопутствующей рекламы). Одновременно с этим она создаёт систему ответов, делающую этот индекс ненужным, и тут же втискивает в неё рекламу так активно, как только позволяет формат: спонсорские изображения, смешанные с результатами поиска по картинкам; реклама внутри сводок, сгенерированных ИИ; и пристроенный сбоку полноценный канал для онлайн-торговли. Компания защищает свой старый бизнес, создавая продукт, который его погубит, и продаёт рекламу на этом «орудии убийства».

Кто платит за доступ
Прежняя схема была честной сделкой — и даже весьма щедрой. «Пустите нашего поискового робота бесплатно, — говорила Google, — и мы направим к вам читателей». Владельцы сайтов не просто мирились со сканированием — они боролись за то, чтобы их сайты сканировались быстрее и индексировались глубже, ведь это был путь к аудитории.
Сканирование для нужд ИИ не предлагает ничего подобного. Система берёт тот же контент, перерабатывает его в готовый ответ и не возвращает взамен ровным счётом ничего: ни клика, ни читателя, ни возможности продать рекламу.
В июле 2025 года компания Cloudflare, через чью инфраструктуру проходит около пятой части всего веб-трафика, открыто озвучила то, о чём раньше предпочитали молчать: прежняя модель больше не работает. Теперь новые сайты в сети Cloudflare блокируют ИИ-роботов по умолчанию, а владельцы могут взимать плату за каждое сканирование через специальную торговую площадку; любой бот, не желающий платить, получает вежливое уведомление «требуется оплата» — и больше ничего. Тридцать лет уговоров в адрес Google с просьбой сканировать сайты активнее — и вот теперь естественной реакцией становится установка платного шлагбаума.
В Великобритании 31 издатель контента пошёл дальше простой блокировки. Они превратили старый файл robots.txt — это вежливое «пожалуйста, не надо», которое поисковые роботы научились игнорировать, — в юридически обязывающий договор: загрузив страницу и использовав статью без оплаты, вы тем самым соглашаетесь на выставление счёта в 500 фунтов стерлингов, взыскать который можно через суд так же, как и любой другой долг. Пока что никому не удалось реально взыскать эти деньги с OpenAI, но такой шаг ясно показывает, к чему всё идёт. У доступа к контенту появился ценник.
Почему именно сейчас, а не пять лет назад, когда начался массовый сбор данных (скрейпинг)? Потому что тексты стали дефицитным ресурсом. Когда качество модели напрямую зависит от текстов, на которых она обучается, а открытый интернет заполняется «выхлопом» самой же модели, подлинные авторские тексты перестают быть просто сырьём и превращаются в ценный актив. Владельцы контента осознали, что именно они контролируют входящие данные, а у данных есть цена.
Так что следите за тем, что они делают на самом деле, ведь именно в действиях кроется суть спора. The New York Times подаёт в суд на OpenAI за использование своего архива для обучения нейросетей и одновременно с этим лицензирует тот же самый архив для Amazon.
OpenAI уже заключила соглашения с The Guardian, The Atlantic, The Washington Post, News Corp и целым рядом других изданий. Никто из этого списка не пытается прогнать машины. Они торгуются лишь о цене. Джинн уже выпущен из бутылки, спрос носит структурный характер, и спор никогда не шёл о том, произойдёт ли это вообще. Вопрос лишь в том, кто и сколько за это получит. Дорога будет построена в любом случае; спорят лишь о размере дорожного сбора.
Что сегодня считается мошенничеством
Существует правило, которое старше всех остальных: никогда не показывайте поисковому роботу контент, отличный от того, который видит пользователь. Это называется «клоакингом», а за клоакинг сайт удаляют из выдачи. Каждый SEO-специалист узнает об этом в первый же день работы.
Но стоит обратиться к официальному определению Google, а не к расхожим мифам. Клоакинг — это демонстрация разного контента пользователям и поисковым системам с целью манипулирования позициями в выдаче и введения людей в заблуждение. Нарушением это делал не сам факт различия версий, а скрытое намерение обмануть. Показать поисковому роботу страницу об отпуске, а человеку — страницу, где продаются поддельные лекарства, — это клоакинг. А вот предоставление тех же сведений в более чистом, машиночитаемом виде, системе, которая воспринимает только такой формат, — это не клоакинг и никогда им не считалось. В рекомендациях Google сказано именно это: меняйте способ подачи как угодно, лишь бы суть оставалась неизменной.
Поэтому, если «читатель» — это ИИ-агент, которому нужны структурированные данные, а не ваше заглавное изображение или баннер с уведомлением о файлах cookie, то предоставление ему структурированных данных не является уловкой. Это ответ на том языке, на котором был сделан запрос. Табу возникло из предположения, что поисковый робот — это просто замена человеческому глазу. Стоит отбросить это допущение, и большая часть табу теряет смысл.
Здесь мне придётся на мгновение побыть занудой, помнящим времена борьбы с веб-спамом, ведь грань всё ещё существует — она просто сместилась. Если вы лжёте машине ради улучшения позиций или скармливаете ей то, под чем никогда не подписались бы в разговоре с живым человеком, это по-прежнему будет расцениваться как намерение обмануть. А в сферах, касающихся здоровья, финансов или любых других областей, где неверный ответ может кому-то навредить, это ещё и опасно. Граница проходит именно там, где начинается обман. Форматирование контента для читателя, который оказался машиной, никогда не было нарушением этой границы.
Что остаётся людям
Всё это — не прогнозы на будущее. Это уже произошло с теми сегментами интернета, которые наиболее важны для машин, и процесс распространяется дальше. Направление развития не вызывает сомнений. Единственные открытые вопросы касаются условий: кто будет получать деньги, кого отсекут от доступа, и чья бизнес-модель завоюет право определять, каким должен быть качественный ответ.
Последний вопрос остается совершенно открытым, и за ним стоит внимательно следить, поскольку создатели этих новых «входных ворот» в интернет пока не могут договориться о том, как на них зарабатывать.
Google встраивает рекламу прямо в ответы. Perplexity экспериментировала с рекламой, но отказалась от неё, настаивая, что пользователь должен верить: он получает лучший ответ, а не тот, за который больше заплатили. Anthropic сохраняет Claude свободным от рекламы и громко об этом заявляет. OpenAI тестирует рекламу, обещая, что она не повлияет на содержание ответов, — именно такие обещания когда-то давала Google насчёт результатов поиска, и мы все помним, чем это обернулось.

Тот, кто победит в этом споре, унаследует роль «надзирателя» и получит право определять понятие «хорошего» для интернета, который большинство людей теперь воспринимает лишь опосредованно.
Для всех нас это оставляет иную, более необычную задачу. Интернету, ориентированному на машинное чтение, нет дела до остроумных заголовков или эффектного дизайна страниц. Его нельзя очаровать или задобрить лестью.
Машина отбирает лишь то, что полезно для формирования ответа, и отбрасывает всё остальное. Это означает, что ценность сохраняет лишь суть, скрытая за внешним оформлением: оригинальные материалы и способность оценить правильность ответа ещё до того, как он попадет к человеку, готовому действовать на его основе.
Тридцать лет интернет учился работать на людей. Теперь же ему предстоит стать полезным для того, у кого нет ни больших пальцев, чтобы показать «класс», ни ладоней, чтобы аплодировать.

СТАТЬИ ИЗ РУБРИКИ:
- Подтвердите что вы не робот: как защита сайта может выкинуть страницы из Google
- Почему ИИ-детекторы не узнают тексты, написанные человеком
- Google UCP: ИИ нашёл ваш сайт, а сможет ли он на нём купить?
- ChatGPT, Perplexity и Google цитируют разные сайты: совпадают лишь 2,37% URL
- Ваш сайт становится необязательным: ИИ строит интернет для ИИ
- Google готовит поиск без людей: что WebMCP изменит в SEO
- Экспертный промпт может делать ответы ChatGPT и других ИИ хуже
- Контентный барьер умер: что ИИ-поиск будет цитировать вместо ваших статей
- Google AI Overviews сократили топовый органический CTR в Германии на 59%
- Расчётный счёт для ИП: быстро открыть и выгодно вести


